Обзор за 5 секунд
Ищем слова, частота которых статистически связана с авторством, — по той же логике, по которой GWAS ищет связи генетических вариантов с признаками.
Краткое содержание
Можно ли искать авторские особенности так же, как генетики ищут варианты ДНК, связанные с ростом или заболеванием? В GWAS каждый генетический маркер проверяют отдельно. Мы переносим эту логику на язык: маркером становится частота слова, а изучаемым признаком — авторство текста.
Берём тексты с известными авторами, делим их на сопоставимые фрагменты и считаем частоты слов. Затем выбираем писателя и для каждого слова задаём один вопрос: меняется ли вероятность того, что фрагмент принадлежит этому автору, вместе с частотой слова?
Так получаем карту лексических ассоциаций. У каждого слова есть направление и сила связи — коэффициент β — и p-значение для проверки гипотезы, что связи нет. Поправка на тысячи одновременно проверяемых слов помогает отсеять случайные находки. В результате можно увидеть и слова, характерные для автора, и те, которые сравнительно редко встречаются в его текстах.
Частотный авторский профиль = ДНК, Авторство = фенотип
Частотный профиль показывает, как часто в тексте встречается каждое слово. В нашей аналогии он играет роль ДНК, а авторство соответствует фенотипу. Мы хотим понять, какие особенности этого профиля связаны с конкретным писателем.
Возьмём слово «чувствовать». Посчитаем его частоту во фрагментах Толстого и других авторов, приведём значения к общему масштабу и проверим, есть ли связь с авторством. Так же генетики проверяют связь отдельного маркера с изучаемым признаком. Эту процедуру повторяем для всех слов.
В нашем исследовании более высокая частота «чувствовать» оказалась связана с авторством Толстого. Связь сохранила статистическую значимость после поправки на множество проверок. Собрав такие результаты для разных слов, мы получаем подробный портрет авторской речи и можем вернуться к текстам, чтобы понять, за счёт чего он складывается.
Подход и результаты описаны в разделах 2–3 статьи. Работа представлена на DH2026 и доступна как препринт.
Как устроен подход
Готовим сопоставимые профили
Приводим слова к начальной форме и делим каждое произведение на непересекающиеся фрагменты по 10 000 лемм. В статье анализируем 5 000 самых частотных лемм каждого корпуса и стандартизируем их частоты.
Проверяем каждое слово отдельно
Для каждой леммы строим отдельную логистическую регрессию: связана ли её частота с тем, что фрагмент принадлежит изучаемому автору, а не кому-то из остальных? Коэффициент β показывает направление и силу этой связи.
Учитываем тысячи проверок
Используем поправку Бонферрони: делаем порог значимости строже с учётом числа проверок. Например, при 5 000 тестов и общем уровне 0,05 порог составит 0,05 / 5 000 = 0,00001.
Проверяем общую картину
Строим карту связей слов с авторством и сравниваем число значимых слов с результатом случайного перемешивания авторских меток. Для всех трёх изученных авторов в статье значимых признаков оказалось больше, чем ожидалось при случайной разметке.
Как читать график
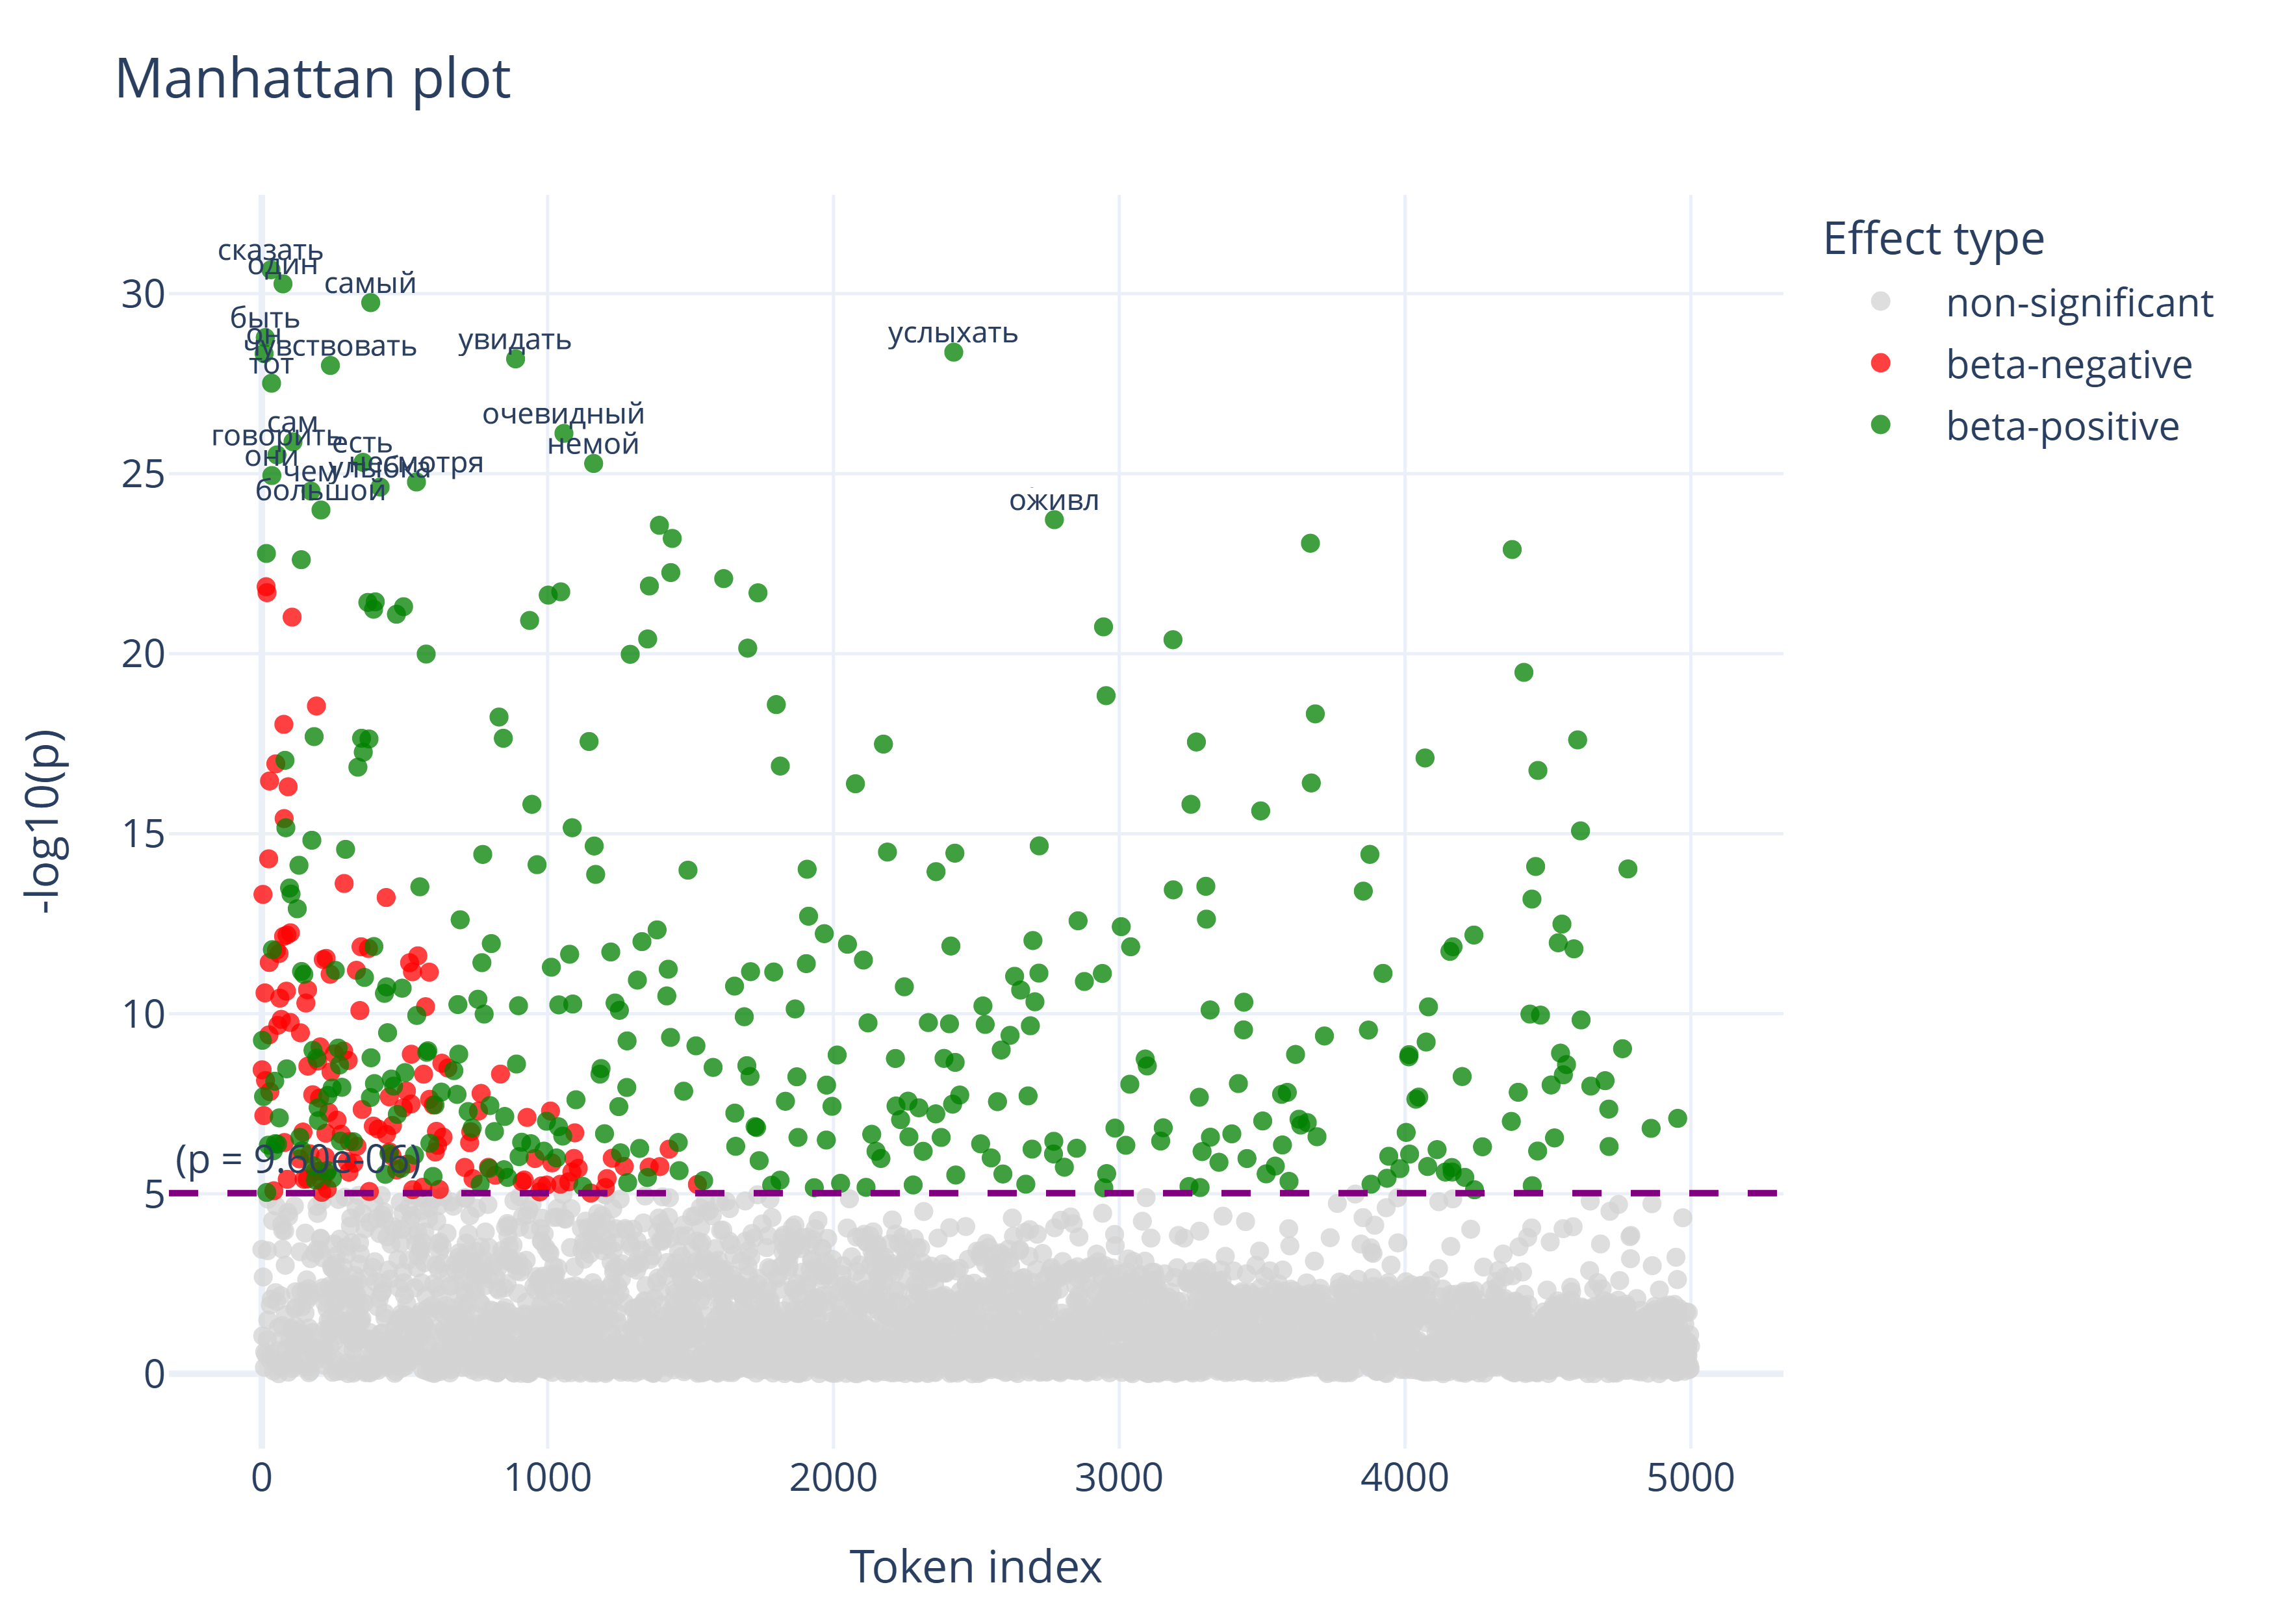
На Manhattan-графике показан анализ Льва Толстого в сравнении с остальными авторами русского корпуса. Каждая точка — лемма. По горизонтали указан её номер в списке признаков; по вертикали — −log₁₀(p), мера статистического свидетельства против гипотезы об отсутствии связи. Чем выше точка, тем меньше p-значение.
Открыть график в полном размере · Источник графика

Зелёный: более высокая частота слова связана с Толстым. Красный: с остальными авторами. Серый: связь не достигает скорректированного порога значимости. Цвет показывает направление связи, высота — статистическую убедительность, а не размер эффекта.
Например, среди положительных сигналов видны «сказать», «чувствовать», «увидать», «услыхать». Это конкретные отправные точки для чтения: можно исследовать, как в этих текстах передаются речь и восприятие.
В статье также выявлены лексические сигналы Герберта Уэллса и Германа Гессе в английском и немецком корпусах. Эти связи описывают выбранные данные; отделение авторства от жанра и эпохи с помощью дополнительных переменных модели предложено как следующий шаг.
Попробовать на своих текстах
В репозитории есть ноутбук анализа, код лемматизации, зависимости, иллюстрации и презентация DH2026. Сначала воспроизведите готовый пример и проверьте разметку авторства и предобработку, затем подставляйте собственные тексты.
Код и ноутбуки ↗Как цитировать
From Genes to Tokens: a GWAS-inspired Approach for Interpretable Stylometric Analysis. arXiv:2606.09543 · Digital Humanities 2026.
BibTeX
@misc{pronin2026genes,
  author = {Pronin, Dmitry and Kazartsev, Evgeny},
  title = {From Genes to Tokens: a GWAS-inspired Approach for Interpretable Stylometric Analysis},
  year = {2026},
  eprint = {2606.09543},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2606.09543}
}